Pregunta a un equipo de Recursos Humanos si su proceso de selección incluye entrevista estructurada y lo más probable es que la respuesta sea sí. Existe una guía con preguntas para el puesto, se les hacen a todos los candidatos y a veces incluso en el mismo orden. Y aun así, cuando llega el momento de decidir entre dos finalistas, la conversación puede terminar girando en torno a quién convenció más, no a qué demostró cada uno.
Esa escena tiene una explicación técnica. La investigación distingue dos dimensiones de la estructura de una entrevista: qué se pregunta y cómo se valora la respuesta (Campion et al., 1997). Un guion resuelve la primera. La segunda —criterios de valoración definidos antes de entrevistar y evidencia registrada antes de calificar— es la que permite comparar candidatos, y es la que con más facilidad queda incompleta. En un estudio con profesionales de Recursos Humanos que entrevistaban con regularidad, predominaban niveles parciales de estructura: se delimitaban los temas de la entrevista y se valoraba mediante varios criterios, sin llegar a los niveles más altos de estandarización (Lievens y De Paepe, 2004). Tener una guía, por tanto, no asegura que el proceso esté lo bastante estructurado para comparar candidatos.
Este whitepaper recorre las tres piezas que completan una entrevista estructurada: preguntas que se derivan del puesto, criterios comunes de valoración y un registro de evidencias que permita justificar cada calificación. También revisa lo que la estructura no resuelve, porque una entrevista bien diseñada reduce el error del entrevistador pero no lo elimina. Lo acompaña una guía de entrevista con rúbrica y formato de registro, pensada para aplicarse en la siguiente vacante sin necesidad de rediseñar todo el proceso.
Evaluar con ciencia también significa poder explicar, después de la entrevista, por qué cada candidato obtuvo la calificación que obtuvo.
En la práctica, tener una entrevista estructurada puede significar tener un documento: una lista de preguntas por puesto, quizá con espacio para anotar. Es un avance frente a la conversación libre, en la que cada entrevistador decide sobre la marcha qué preguntar. Pero si esa lista no viene acompañada de una definición previa de qué respuesta vale más que otra, dos entrevistadores pueden escuchar lo mismo y calificar distinto, y ninguno de los dos estará equivocado según sus propios criterios. El problema es que no comparten criterios.
La literatura describe la estructura como un conjunto de componentes, no como un atributo que se tiene o no se tiene. Campion et al. (1997) identificaron quince componentes y los separaron en dos grupos: los que mejoran el contenido de la entrevista —qué se pregunta y cómo— y los que mejoran el proceso de evaluación —cómo se registra y se califica lo que el candidato responde—. Alonso (2011) retoma esa distinción para describir la estructura como un continuo con dos ejes. En el eje de las preguntas, el extremo más bajo deja al entrevistador libre de preguntar lo que considere; el más alto plantea las mismas preguntas, en el mismo orden, a todos. En el eje de la valoración, el extremo más bajo es una evaluación global al terminar la entrevista; el más alto califica cada respuesta por separado, contra una escala construida para esa pregunta.
Esta distinción importa porque los dos ejes no avanzan juntos. Lievens y De Paepe (2004) estudiaron a profesionales de Recursos Humanos con experiencia en entrevistas y encontraron que en la mayoría de las entrevistas la estructura se concentraba en definir los temas que había que cubrir, y que la valoración se hacía sobre varios criterios, sin llegar a calificar cada respuesta contra una escala propia. El mismo estudio identificó por qué: quienes daban más peso a establecer un contacto informal con el candidato, a conservar libertad sobre las preguntas o a preparar la entrevista rápido tendían a usar menos estructura. En cambio, quienes habían participado en talleres de entrevista reportaban niveles de estructura más altos. La muestra fue belga, por lo que estos resultados no describen directamente la práctica mexicana. Sí señalan barreras que conviene explorar en cada equipo: la preferencia por una conversación informal, la autonomía para preguntar y el tiempo necesario para preparar la entrevista.
Hay además una razón menos evidente. Highhouse (2008) describe dos creencias implícitas que frenan la adopción de herramientas estructuradas en selección. La primera es que, en teoría, sería posible predecir el desempeño casi a la perfección, de modo que cualquier método que admita error parece insuficiente. La segunda es que la capacidad de predecir el comportamiento humano mejora con la experiencia. Esta segunda creencia —lo que el autor llama el mito de la experiencia— lleva a confiar en la intuición y a resistirse a usar un apoyo que parecería restar credibilidad al propio juicio. Un entrevistador experimentado puede sentir que una rúbrica le quita justo aquello en lo que es bueno.
La evidencia sobre el resultado está bien establecida. Levashina et al. (2014) señalan que doce metaanálisis han encontrado de manera consistente que las entrevistas estructuradas son más confiables y más válidas que las no estructuradas. La revisión de las estimaciones de validez en selección de Sackett et al. (2022) ubica a la entrevista estructurada con la validez operativa media más alta entre los procedimientos analizados, alrededor de .42, pero también con una variación considerable entre estudios. Ese segundo dato es el que interesa en este documento: que una entrevista estructurada pueda predecir bien no garantiza que la tuya lo haga, porque el resultado depende, entre otros factores, de cómo se diseñó y se aplicó. Por qué la intuición pierde frente a los métodos estructurados está desarrollado en Contra el feeling: cuatro razones por las que la intuición pierde dinero; aquí el foco está en cómo se construye la estructura que falta.
Tabla 1. Estructura aparente frente a estructura sustantiva
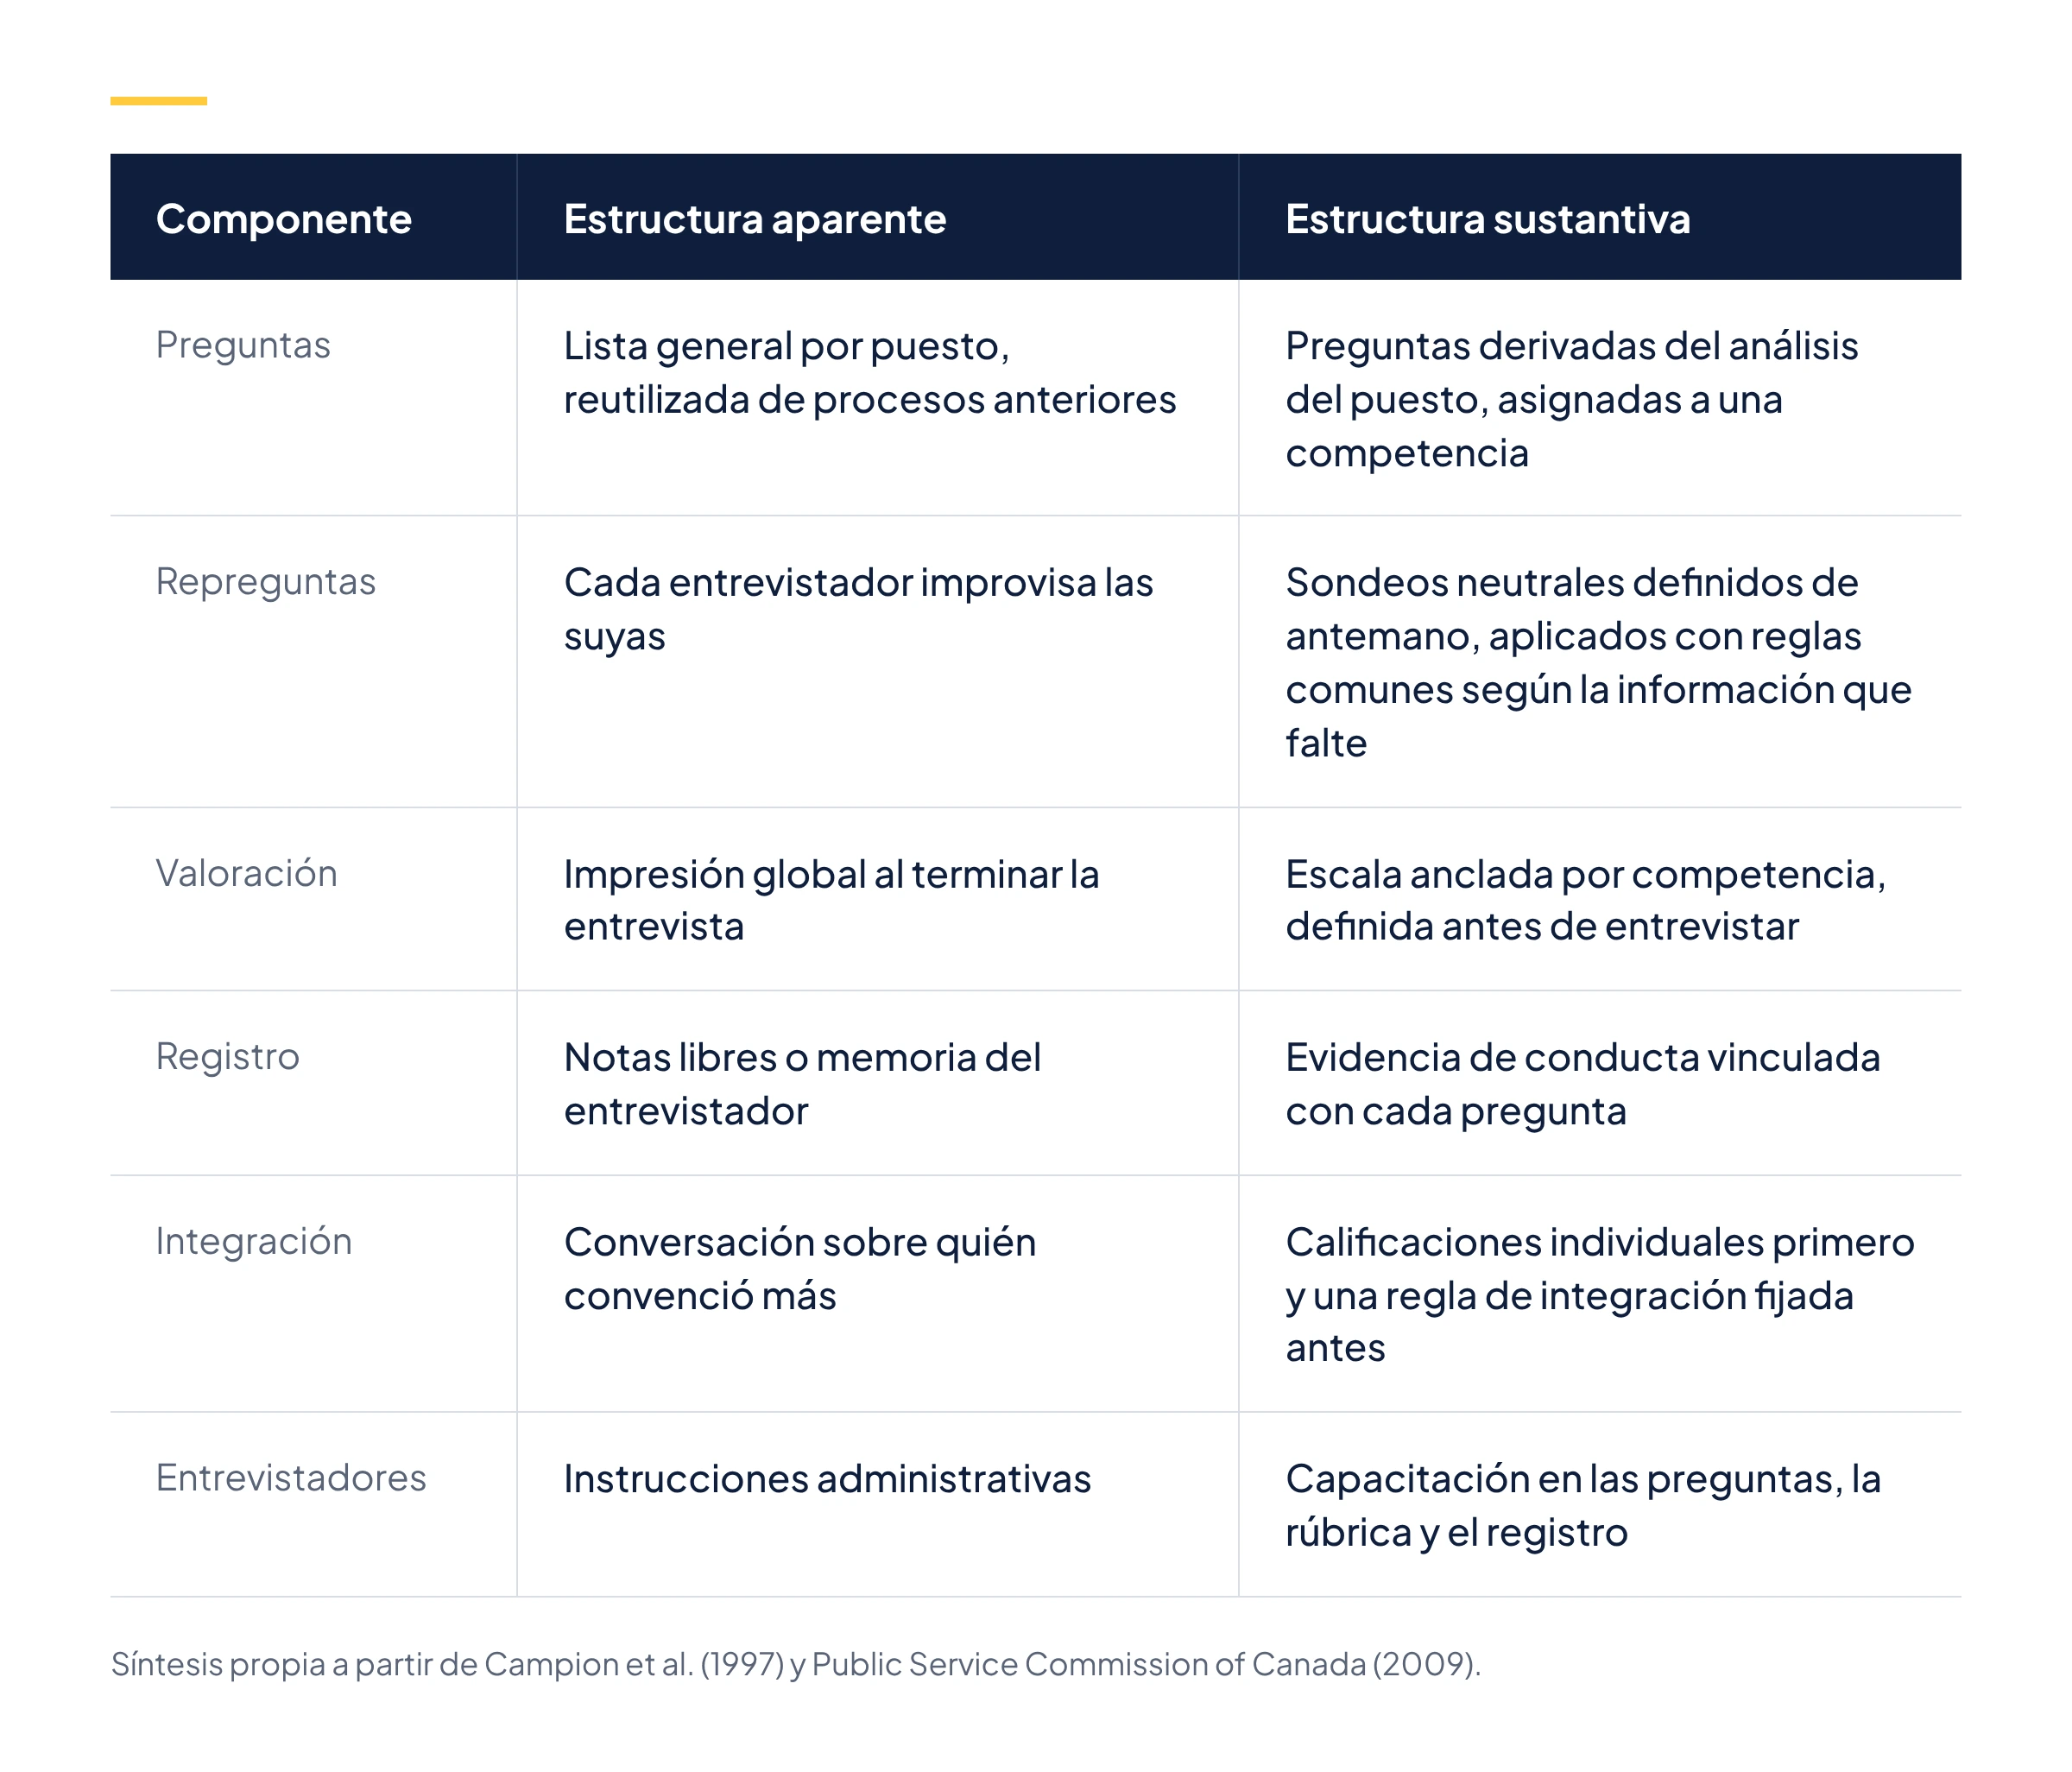
Hacer las mismas preguntas a todos los candidatos es solo la mitad de la estructura. La otra mitad es decidir de antemano qué cuenta como una buena respuesta.
Una guía de entrevista puede terminar heredando preguntas que nadie recuerda quién escribió: dónde se ve el candidato en cinco años, cuál es su mayor defecto, por qué quiere trabajar aquí. No son preguntas prohibidas ni necesariamente inútiles. Su problema es otro: como no salieron del puesto, no existe un criterio para decidir qué respuesta es mejor. Cada entrevistador termina valorándolas según lo que a él le parece una buena respuesta, y ahí la estructura ya se perdió, aunque la pregunta sea la misma para todos.
La alternativa es que cada pregunta pueda rastrearse hasta un requisito del puesto. La norma internacional de lineamientos de reclutamiento señala que la forma más apropiada de desarrollar el perfil de la persona que se busca es un análisis formal y estructurado de requisitos, y que las características del perfil deben reflejar requisitos necesarios y no sesgos personales o discriminatorios (International Organization for Standardization [ISO], 2023). La guía de la Oficina de Administración de Personal del gobierno estadounidense describe la construcción de una entrevista estructurada en ocho pasos que pueden sintetizarse en una secuencia que empieza exactamente ahí (U.S. Office of Personnel Management [OPM], 2008):
El insumo más útil para escribir preguntas es un conjunto de episodios reales de desempeño. La guía de entrevista estructurada de la Comisión de Servicio Público de Canadá recomienda reunir, con supervisores u ocupantes del puesto, ejemplos de desempeño excepcionalmente bueno y excepcionalmente malo en la competencia que se quiere evaluar, y construir las preguntas a partir de ellos (Public Service Commission of Canada [PSC], 2009). Tres preguntas guían ese trabajo: qué distingue a quien es fuerte en esa competencia de quien no lo es, en qué situaciones del puesto se demuestra y qué hace que una forma de actuar sea eficaz o ineficaz. Las respuestas a esas tres preguntas sirven dos veces: producen la pregunta de entrevista y, más adelante, las anclas de la escala.
Un análisis de puesto suele producir más competencias de las que caben en una hora. OPM (2008) indica que una entrevista estructurada normalmente evalúa entre cuatro y seis competencias, salvo en puestos únicos o de nivel alto, y la guía canadiense recomienda no pasar de siete, porque intentar cubrir demasiados factores en poco tiempo produce información superficial (PSC, 2009). Lo que no se evalúa en la entrevista no desaparece del proceso: se evalúa con otro método. La misma guía señala que la capacidad mental suele medirse mejor con pruebas estandarizadas que con preguntas de entrevista. La entrevista rinde más cuando se reserva para lo que se observa mejor en una conversación: cómo alguien describe lo que hizo ante una situación concreta, cómo se comunica, cómo razona frente a un problema del puesto.
Las preguntas conductuales piden un episodio real del pasado y lo que el candidato hizo en él. Las situacionales plantean un escenario hipotético del puesto y preguntan qué haría. Es tentador tratarlas como dos maneras de preguntar lo mismo, pero la evidencia no lo respalda. Un metaanálisis que comparó preguntas situacionales y conductuales escritas para medir exactamente los mismos atributos encontró una correlación media observada de .40 entre ambas (.47 una vez corregida), lo que indica que se relacionan pero no son intercambiables; la correspondencia fue todavía menor cuando no se permitían sondeos (Culbertson et al., 2017). La implicación práctica es elegir el formato por la evidencia que se necesita, no por costumbre.
Las respuestas de los candidatos varían en longitud y detalle, y a veces hace falta pedir más información para poder calificar. Repreguntar no rompe la estructura; improvisar sí. La guía canadiense recomienda desarrollar los sondeos al mismo tiempo que las preguntas, y establece dos límites: el sondeo no debe introducir temas nuevos, porque eso daría a algunos candidatos una oportunidad que otros no tuvieron, y no debe revelar las conductas que se están buscando (PSC, 2009). La guía de OPM agrega que los sondeos pueden adaptarse a la respuesta de cada candidato siempre que su sentido general no cambie (OPM, 2008). Estandarizar no obliga a hacer todos los sondeos a todos: obliga a aplicar la misma regla para completar lo que falta. Los sondeos más útiles son neutrales y buscan completar la estructura de la respuesta: cuál fue exactamente tu papel, qué hiciste primero, qué pasó después, cómo supiste que había funcionado.
Un estudio internacional que incluyó entrevistas realizadas en México no evalúa su validez, pero sí describe qué se pregunta en ellas. Posthuma et al. (2014) compararon entrevistas de México con las de Bélgica, Rusia, Taiwán y Estados Unidos, y encontraron diferencias en quién entrevista y en qué pregunta. Fuera de Estados Unidos, los entrevistadores preguntaban por la familia, el estado civil y los hijos del candidato; en México y Taiwán, además, era menos probable que la entrevista la condujera una mujer. Los autores concluyen que en algunos países la entrevista es algo más que una evaluación de conocimientos, habilidades y capacidades relacionados con el puesto.
Desde el punto de vista de la medición, el problema de esas preguntas es sencillo: su respuesta no se puede calificar contra ningún requisito del puesto, así que lo que añaden a la decisión no es evidencia defendible sobre el desempeño probable, y puede introducir información irrelevante o sesgos. México ya describió una práctica certificable que apunta en la dirección contraria. Uno de los requisitos críticos de la Norma Mexicana en Igualdad Laboral y No Discriminación, vigente y confirmada en su revisión sistemática de 2025, es contar con un proceso de reclutamiento y selección de personal sin discriminación y con igualdad de oportunidades. Entre los elementos con que se acredita figura documentación para entrevista estructurada y/o exámenes o evaluaciones de ingreso libres de sesgos sexistas o de cualquier tipo de discriminación (Secretaría de Economía, 2015, 2025). La norma es voluntaria y el «y/o» importa: no exige la entrevista estructurada; la contempla entre los elementos de un proceso de selección sin discriminación y con igualdad de oportunidades.
Si una pregunta no se puede rastrear hasta un requisito del puesto, nada autoriza a leer su respuesta como evidencia sobre ese puesto.
Una guía de entrevista puede terminar con una escala del 1 al 5 junto a cada competencia. Parece suficiente, pero un número sin definición no es un criterio. Para un entrevistador, un 4 en trabajo en equipo significa que el candidato mencionó haber colaborado con otras áreas; para otro, que resolvió un conflicto entre compañeros. Ambos usan la misma escala y califican cosas distintas. La escala solo se vuelve común cuando cada punto describe qué se tiene que observar en la respuesta para merecerlo.
Eso es lo que hace una escala anclada en conducta: vincula cada nivel con conductas o características observables de la respuesta, en lugar de etiquetas como regular, bueno o excelente. La guía canadiense recomienda construir las anclas a partir de los mismos documentos del puesto que originaron las preguntas y definir, para cada competencia, qué distingue una respuesta débil de una moderada y de una fuerte (PSC, 2009). Propone además dos criterios para valorar la evidencia: la amplitud, es decir, cuántas de las conductas esperadas aparecen en la respuesta y con qué consistencia, y la profundidad, que se refiere a la complejidad, la solidez y la precisión con que se demuestran.
¿Cuántos puntos debe tener la escala? La misma guía indica que suelen usarse entre tres y siete, y que una escala de cinco suele ser adecuada para calificar competencias (PSC, 2009). Conviene leer esa recomendación como lo que es, una práctica institucional razonable, y no como un óptimo demostrado. Más que el número de puntos, lo que conviene cuidar es que cada nivel esté definido con criterios observables que todos los entrevistadores compartan.
Dos decisiones más se toman antes de la primera entrevista. La primera es calificar por competencia y no por candidato: si hay dos preguntas para la misma competencia, el entrevistador integra la evidencia de ambas en una sola calificación de esa competencia (PSC, 2009). La segunda es cuánto pesa cada competencia en el resultado. OPM (s. f.) recomienda asignar el mismo peso a todas salvo que exista una justificación clara y documentada para hacerlo de otro modo. Decidir los pesos después de ver a los candidatos es una forma de volver a la impresión global por la puerta de atrás.
Tabla 3. Ejemplo de escala anclada para una competencia
Competencia: solución de problemas con clientes. Puesto de ejemplo: supervisión de atención a clientes. Pregunta conductual: «Cuéntame de una ocasión en que un cliente llegó con un problema que no se resolvía con el procedimiento habitual. ¿Qué hiciste?» Sondeos previstos: ¿cuál fue exactamente tu papel?, ¿qué opciones consideraste y por qué elegiste esa?, ¿cómo supiste que el problema quedó resuelto?
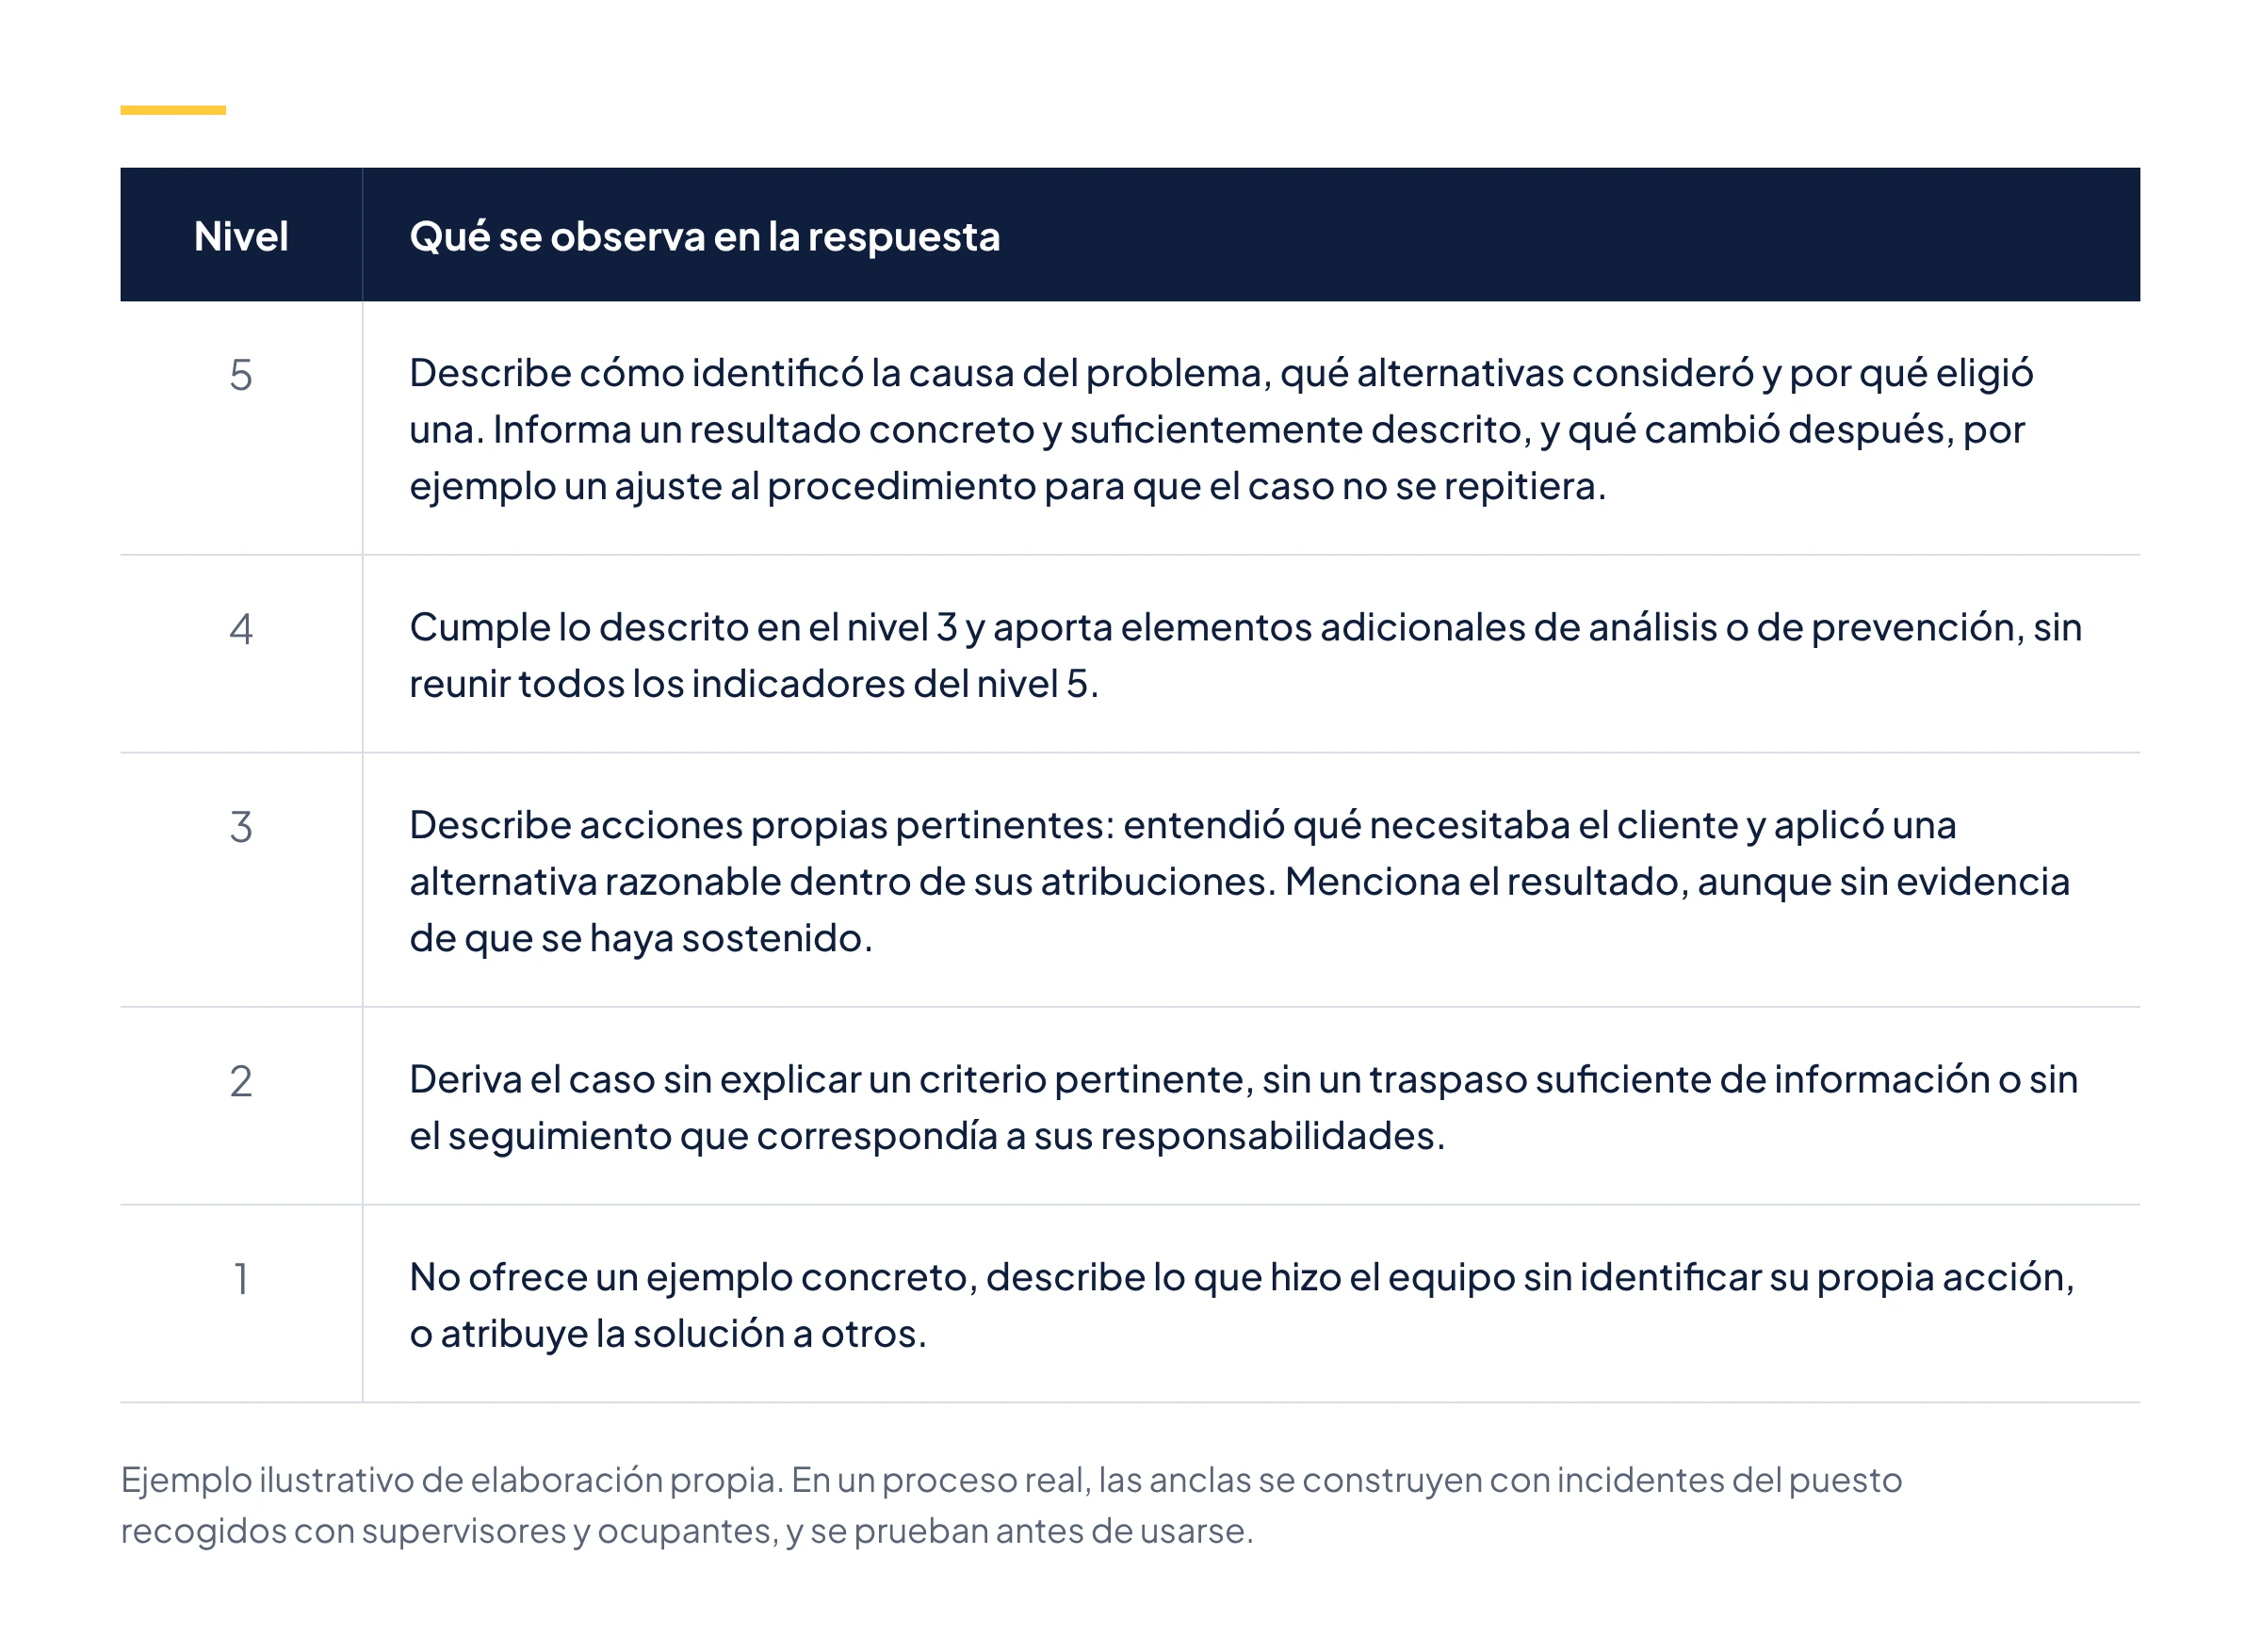
La calificación describe la evidencia aportada en esta entrevista, no la competencia de la persona en general. La guía de OPM lo señala a propósito de las calificaciones bajas: no indican que el candidato carezca de la competencia, sino que la demostró poco en sus respuestas (OPM, 2008). Por eso, antes de aplicar la escala conviene decidir cómo se registrarán los casos en los que, después de los sondeos previstos, no hubo información suficiente para calificar. Puede usarse el nivel más bajo como «competencia no demostrada», siempre que esa interpretación quede escrita desde el principio; lo que debe evitarse es decidirlo después, candidato por candidato.
Una escala anclada reduce las diferencias entre entrevistadores, pero no las elimina, y aquí aparece uno de los datos más útiles para un proceso de selección real. El metaanálisis más completo sobre confiabilidad de la entrevista reunió 125 coeficientes con una muestra total de 32,428 personas y encontró que la confiabilidad entre evaluadores era considerablemente mayor cuando los entrevistadores formaban un panel y escuchaban la misma entrevista que cuando cada uno entrevistaba al candidato por separado: .74 frente a .44 (Huffcutt et al., 2013). Los autores advierten que quien administra entrevistas no debería juzgar la calidad de su proceso con estimaciones que no consideran todas las fuentes de error.
La lectura práctica es directa. Cuando la persona de Recursos Humanos entrevista un día y el jefe del área otro, cada uno con sus preguntas y sus criterios, una parte considerable de la diferencia entre sus calificaciones no viene del candidato. Viene de quién entrevistó, qué preguntó y en qué momento. Dos remedios están al alcance de cualquier proceso. El primero: cuando dos entrevistas evalúan la misma competencia, deben compartir su definición y sus criterios de valoración; cuando evalúan competencias distintas, cada una necesita su propia rúbrica y una regla explícita para integrar los resultados. El segundo: que los entrevistadores se capaciten en la rúbrica antes de usarla. La capacitación no es un trámite: en el estudio de Lievens y De Paepe (2004), quienes habían asistido a talleres de entrevista usaban más estructura, y la guía canadiense la plantea como condición para que el panel comparta una misma interpretación de cada competencia (PSC, 2009).
Sin criterios definidos antes de la entrevista, la calificación dice tanto de quien entrevistó como de quien respondió.
Las notas de muchas entrevistas se parecen entre sí: muy seguro, buena actitud, le falta experiencia, no me convenció. Son conclusiones, no evidencia. Quien las lee días después sabe qué pensó el entrevistador, pero no por qué, y no tiene forma de comparar esa conclusión con la de otro entrevistador que vio a otro candidato. Una nota así solo puede recordarse; no puede revisarse.
La investigación sobre notas en la entrevista es más escasa de lo que su importancia sugeriría, pero lo que existe apunta en una dirección clara. Burnett et al. (1998) encontraron que la relación entre tomar notas y la validez de las calificaciones dependía de cómo se hacía. Cuando tomar notas era voluntario, quienes lo hacían calificaban con más validez. Cuando se asignaba la instrucción, las notas conductuales no superaron a no tomar notas, y las notas generales produjeron calificaciones menos válidas que no tomar notas en absoluto. Al analizar el contenido, las notas de tipo conductual —lo que el candidato describió haber hecho— fueron las que contribuyeron a una mayor validez. Tomar notas no basta: importa qué se registra y cómo se utiliza. La guía canadiense lo formula en términos operativos: las notas deben registrar lo que el candidato dijo o hizo, lo más cerca posible de sus palabras, y no las inferencias o juicios del entrevistador; la calificación no se asigna durante la entrevista, sino inmediatamente después (PSC, 2009).
Separar observación y juicio es más fácil si el formato lo obliga. Un registro útil tiene campos distintos para la evidencia —situación, acción propia y resultado que describió el candidato—, para la conducta de la escala con la que se relaciona, para la información que faltó y no debe suponerse, para la calificación y para su justificación. La justificación es el campo decisivo: una calificación que no puede explicarse con la evidencia anotada es una impresión con número.
Tabla 4. La misma entrevista, registrada de dos maneras
Cuando entrevista más de una persona, el orden de los pasos cambia el resultado. El procedimiento canadiense pide que cada integrante del panel revise sus notas, identifique las conductas demostradas y asigne su calificación de manera independiente antes de cualquier discusión; solo entonces el panel conversa, acuerda una calificación y deja por escrito el resultado y su justificación (PSC, 2009). Calificar antes de conversar reduce el riesgo de que la primera opinión expresada, o la de quien tiene más jerarquía en la sala, sustituya las evaluaciones de los demás.
La regla con la que se combinan las calificaciones también debe fijarse antes de ver a los candidatos. Un metaanálisis sobre decisiones de selección y admisión encontró una pérdida consistente y sustancial de validez cuando la información se combinaba de manera holística, incluso por expertos que conocían el puesto y la organización; en la predicción del desempeño laboral, la combinación mecánica mejoraba la predicción en más de 50 % (Kuncel et al., 2013). Ese estudio combina datos de distintos instrumentos, no solo de la entrevista, así que no demuestra que el promedio sea superior al consenso dentro de un panel. Conviene distinguir dos decisiones. Una es cómo se acuerda la calificación de una entrevista: el consenso documentado de un panel es un procedimiento de valoración, pero no equivale por sí mismo a una combinación mecánica. La otra es cómo se combinan las distintas fuentes de información para decidir a quién seleccionar, y ahí la evidencia favorece reglas explícitas y reproducibles, fijadas antes de conocer los resultados, frente a una apreciación holística del candidato.
Un registro detallado contiene datos personales del candidato, cuyo manejo en México está sujeto a la Ley Federal de Protección de Datos Personales en Posesión de los Particulares. La norma internacional de reclutamiento recomienda establecer lineamientos claros sobre cuánto tiempo se conservan los datos personales identificables, y limitar el acceso a esos datos a quienes tengan derecho a conocerlos (ISO, 2023). Conviene anotar también las desviaciones del procedimiento: una pregunta que no se hizo, una interrupción, un tiempo adicional. Esas notas permiten saber después si dos candidatos fueron evaluados en condiciones comparables.
Lo que no quedó registrado durante la entrevista no se puede comparar después. Solo se puede recordar.
Una entrevista estructurada bien construida reduce varias fuentes de error. No las elimina, y un documento que prometiera lo contrario haría un mal servicio a quien lo aplique. Dos fenómenos persisten incluso en procesos con alto nivel de estructura, y conocerlos permite diseñar contra ellos.
Cuando una entrevista empieza con unos minutos de conversación informal, lo que el entrevistador concluye en ese arranque no se queda ahí. Barrick et al. (2010) encontraron que las impresiones iniciales se relacionaban con las calificaciones al final de la entrevista y con las ofertas de prácticas profesionales que recibieron los candidatos, incluso cuando las calificaciones las daba otro entrevistador. Un estudio posterior con 130 entrevistas simuladas encontró una relación fuerte entre la impresión inicial y la evaluación de las respuestas a preguntas altamente estructuradas; esas impresiones se asociaban con la extraversión y la habilidad verbal del candidato, aun controlando sus calificaciones para el puesto (Barrick et al., 2012).
Conviene no leer esto como la prueba de que la primera impresión es puro sesgo. Los propios autores del primer estudio sugieren que esas impresiones pueden basarse en juicios útiles sobre la competencia del candidato formados en los primeros minutos (Barrick et al., 2010). El problema no es que el entrevistador se forme una impresión, cosa que no puede evitar, sino que esa impresión califique en lugar de la evidencia. Por eso la calificación se asigna después, contra las anclas y a partir de lo anotado, y no durante la conversación.
El segundo fenómeno tiene que ver con el orden. Radbruch y Schiprowski (2025) analizaron cerca de 37,000 entrevistas de dos procesos de alta exigencia en Alemania, uno de admisión a un programa de becas y otro de contratación en una empresa de consultoría, con asignación prácticamente aleatoria de candidatos y horarios. Encontraron que la recomendación sobre un candidato dependía de la calidad del candidato entrevistado justo antes, al punto de alterar las decisiones finales. El efecto era mayor cuando había poco tiempo entre una entrevista y otra, cuando los dos candidatos compartían características y en las primeras entrevistas de la jornada.
El efecto apareció en dos procesos que reunían evaluaciones independientes de cada candidato, aunque sus condiciones no eran idénticas. Resulta especialmente relevante que también se observara en la consultoría, donde los evaluadores estaban capacitados para realizar entrevistas estructuradas y lo hacían con regularidad. La experiencia acumulada y la capacitación adicional no atenuaron el efecto, y una intervención que informó a los evaluadores sobre el problema tampoco lo redujo. Avisarle al entrevistador no basta. Los datos sugieren revisar el diseño del proceso, sin suponer que una medida aislada eliminará el efecto: la influencia fue menor cuando había más tiempo entre entrevistas, y las simulaciones de los autores indican que reunir más evaluaciones independientes la atenúa, aunque lentamente. Calificar a cada candidato contra las anclas y no contra el anterior es la recomendación de este documento, no una intervención probada en ese estudio.
Frente a esos límites hay resultados que juegan a favor. Un metaanálisis en español que reunió 12 muestras con 32,525 personas no encontró diferencias en las puntuaciones de hombres y mujeres en ninguna de las modalidades de entrevista estructurada analizadas (Alonso, 2011). La propia autora advierte que la mayor parte de la muestra proviene de dos estudios realizados en un mismo país, España, y que hacen falta más estudios en otros contextos; no es evidencia mexicana y no debe leerse como tal. Sobre la experiencia del candidato, un metaanálisis con 38 muestras de 17 países encontró que las entrevistas y las muestras de trabajo están entre los métodos de evaluación mejor valorados por los candidatos (Anderson et al., 2010); ese estudio evalúa la entrevista en general, no el efecto de estructurarla. Lo que sí está al alcance del diseño es que estructurar la evaluación no vuelva fría la conversación: la guía canadiense recomienda empezar de manera cordial, explicar al candidato el formato y reservar un espacio al final para sus preguntas (PSC, 2009).
Queda un último límite, que es también una conclusión. Una entrevista, por bien diseñada que esté, solo obtiene evidencia sobre las competencias y situaciones que sus preguntas permiten observar, y lo que el candidato no mostró en ella no equivale a lo que no sabe hacer: puede ser simplemente evidencia insuficiente. La entrevista estructurada es una fuente entre varias, no un veredicto. Rinde más cuando se integra con otras formas de evidencia sobre el candidato, cada una evaluando lo que mide mejor, con una regla de integración decidida antes de conocer los resultados.
La estructura reduce el ruido de la entrevista, no lo apaga. Por eso se diseña contra él, en lugar de confiar en la buena voluntad del entrevistador.
Pedirle a un proceso de selección que decida de antemano qué cuenta como buena respuesta obliga también a quien lo pide. Durante más de 15 años, y a lo largo de más de 25 millones de evaluaciones aplicadas en 25 países en habla hispana, hemos sostenido que ninguna herramienta debería decidir sola. Este documento nos compromete a:
Evaluar con ciencia es poder mostrar el camino que va de la evidencia a la decisión. Encuentra más recursos en psicotest.mx.
Si ya entrevistas para una vacante abierta: descarga sin costo la guía de entrevista con rúbrica y formato de registro que acompaña este documento. Antes de la primera entrevista, define las competencias, escribe las anclas y acuerda con los demás entrevistadores cómo se integrarán las calificaciones.
Si quieres profundizar en por qué la estructura importa: lee Contra el feeling: cuatro razones por las que la intuición pierde dinero y consulta en psicotest.mx nuestro curso, webinars y blog
México merece psicometría hecha para México. Psicotest es una plataforma de evaluación psicométrica con más de 15 años de trayectoria y más de 25 millones de evaluaciones aplicadas en 25 países en habla hispana.
Entendemos la psicometría como ciencia aplicada y no como ritual: cada instrumento que ofrecemos debe poder explicar qué mide, con qué precisión y para qué decisiones sirve. Por eso documentamos nuestros instrumentos y publicamos contenido que ayuda a las organizaciones a usar la evidencia con criterio, incluida la de otras fuentes.
Nuestro trabajo cabe en una frase: evaluar con ciencia, para que las decisiones sobre personas se tomen con la mejor evidencia disponible.
Aurora Martínez coordina el área de investigación de Psicotest. Lleva más de 10 años trabajando en psicometría aplicada a la selección de personal y su interés principal es que estos conceptos sean comprensibles para quienes toman decisiones, sin perder el rigor que la disciplina exige.
Este documento tiene fines informativos y no sustituye la asesoría profesional especializada para casos particulares.


